Блог

13
Теневой расчёт: как сравнить новую обработку со старой до переключения
Новый отчёт можно считать параллельно с рабочим, сохраняя его результат отдельно. Объясняем, что сравнивать, как разбирать расхождения и почему копирование входных данных само по себе не проверка.

14
Почему одинаковые слова сортируются по-разному в разных базах
Буквы, регистр и цифры в названии требуют правил сравнения. Объясняем collation на примере каталога и разбираем, что проверить при переносе списка между системами.

16
Формула и сохранённое значение Excel: что переносится в выгрузку
В книге Excel может храниться и правило расчёта, и прежний результат. Объясняем, почему чтение файла не всегда пересчитывает ячейки и что согласовать перед переносом данных.

11
Как Spark продолжает обработку потока после перезапуска
После остановки нужно знать, какие события уже обработаны и какой итог накоплен. Объясняем роль потоковой контрольной точки, источника и получателя результата без кода.

8
Когда учебный кейс стоит разбирать вместе с командой
Если у задачи несколько обоснованных решений, важно обсудить причины выбора. Предлагаем порядок группового разбора кейса и объясняем, как увидеть вклад каждого участника.

14
Формат таблицы поверх файлов: зачем нужны Iceberg, Delta Lake и Hudi
После исправления данных в папке могут остаться и старые, и новые файлы. Объясняем, как табличные форматы определяют принятый состав таблицы и почему читать все файлы подряд опасно.

15
Канареечный выпуск: как проверить изменение до массового включения
Новое правило готово, но включать его сразу для всех рискованно. Объясняем ограниченный пробный выпуск, выбор наблюдений и особенности изменений в системах данных.


Занятия проходят
в Нова Дата СДО
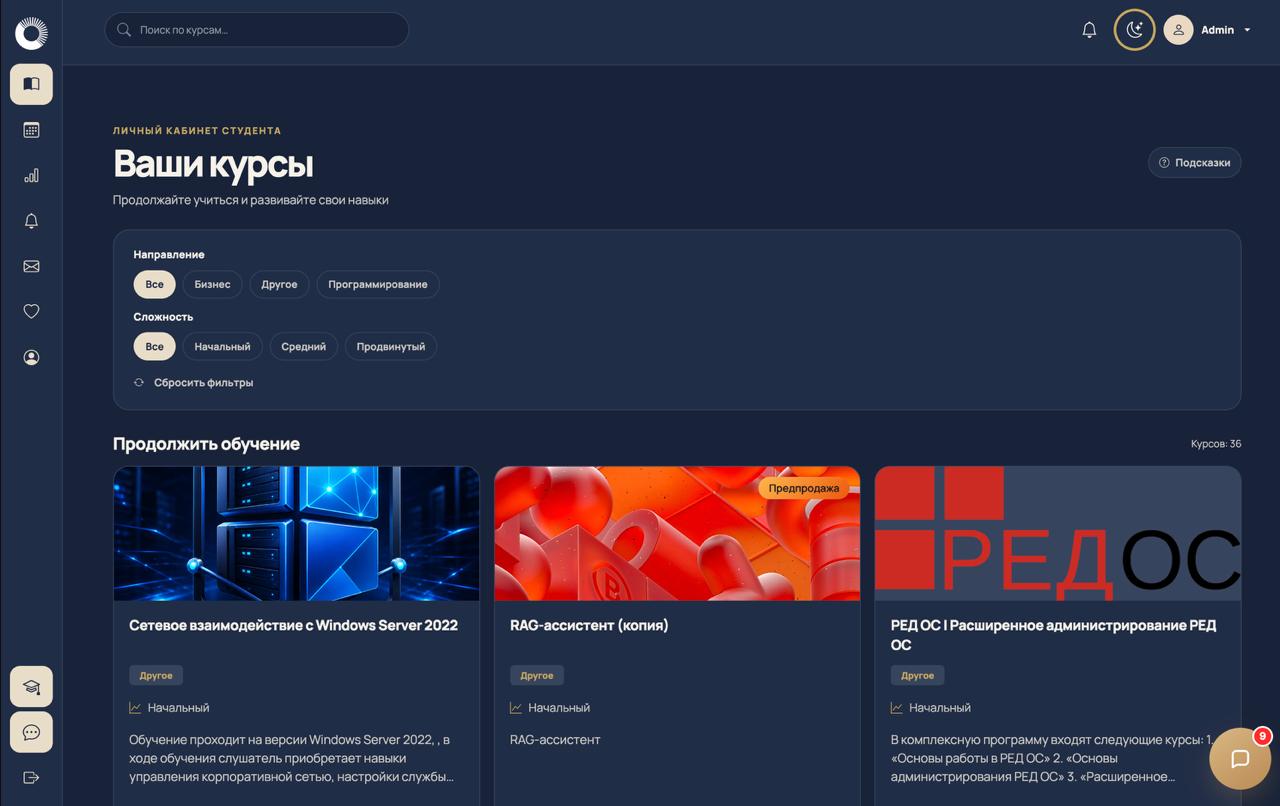
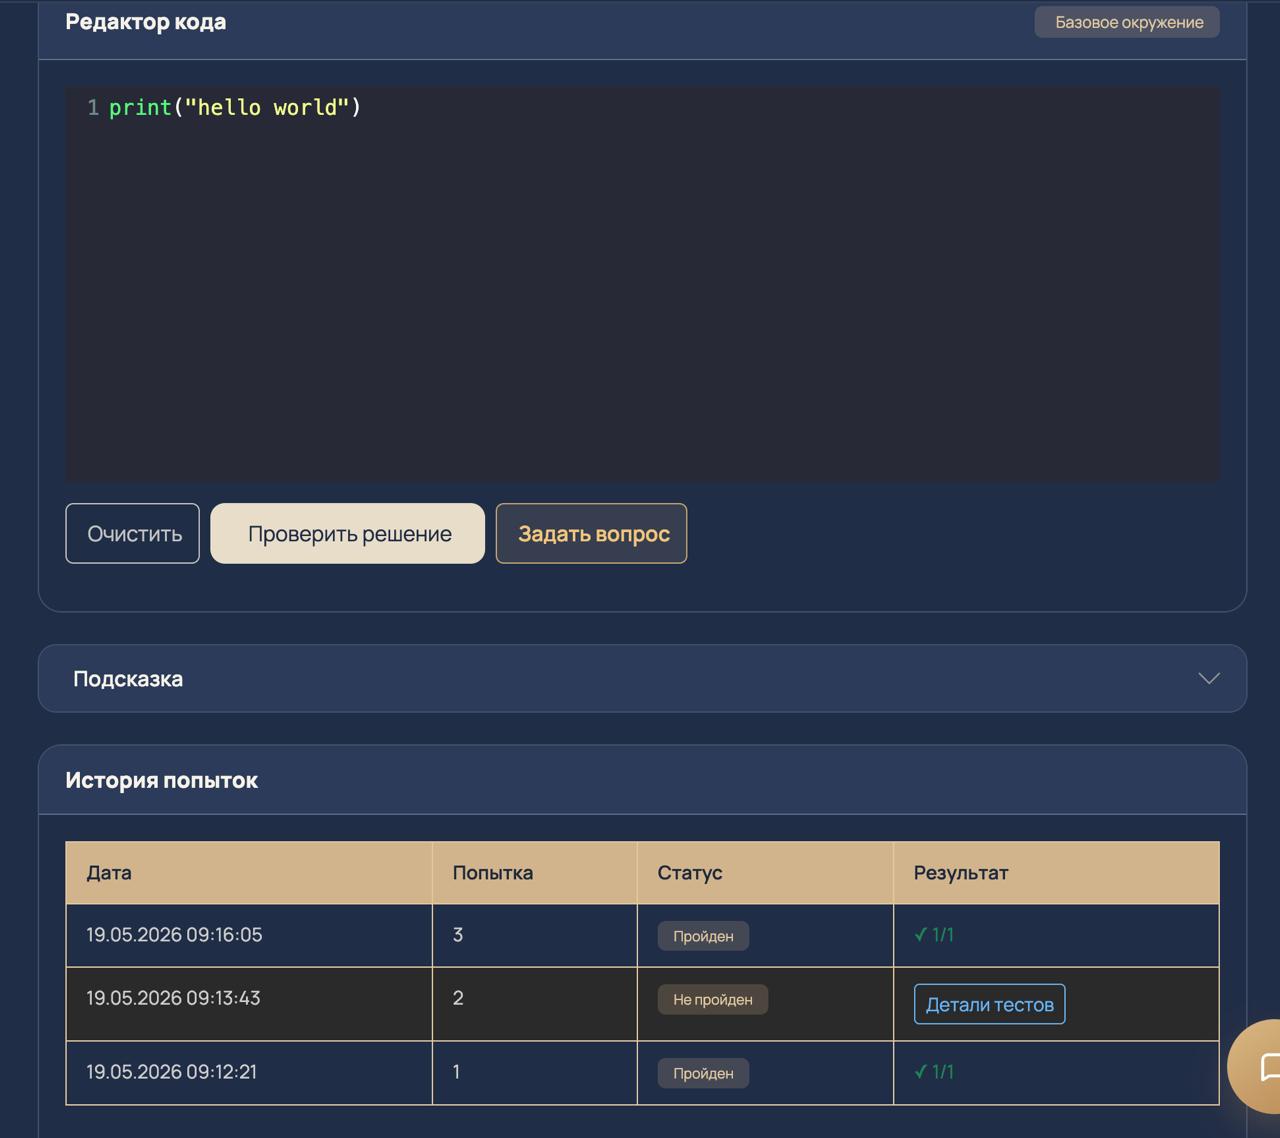
Вебинары, практика и общение с преподавателем — в одном окне браузера.
Посмотреть интерфейс платформы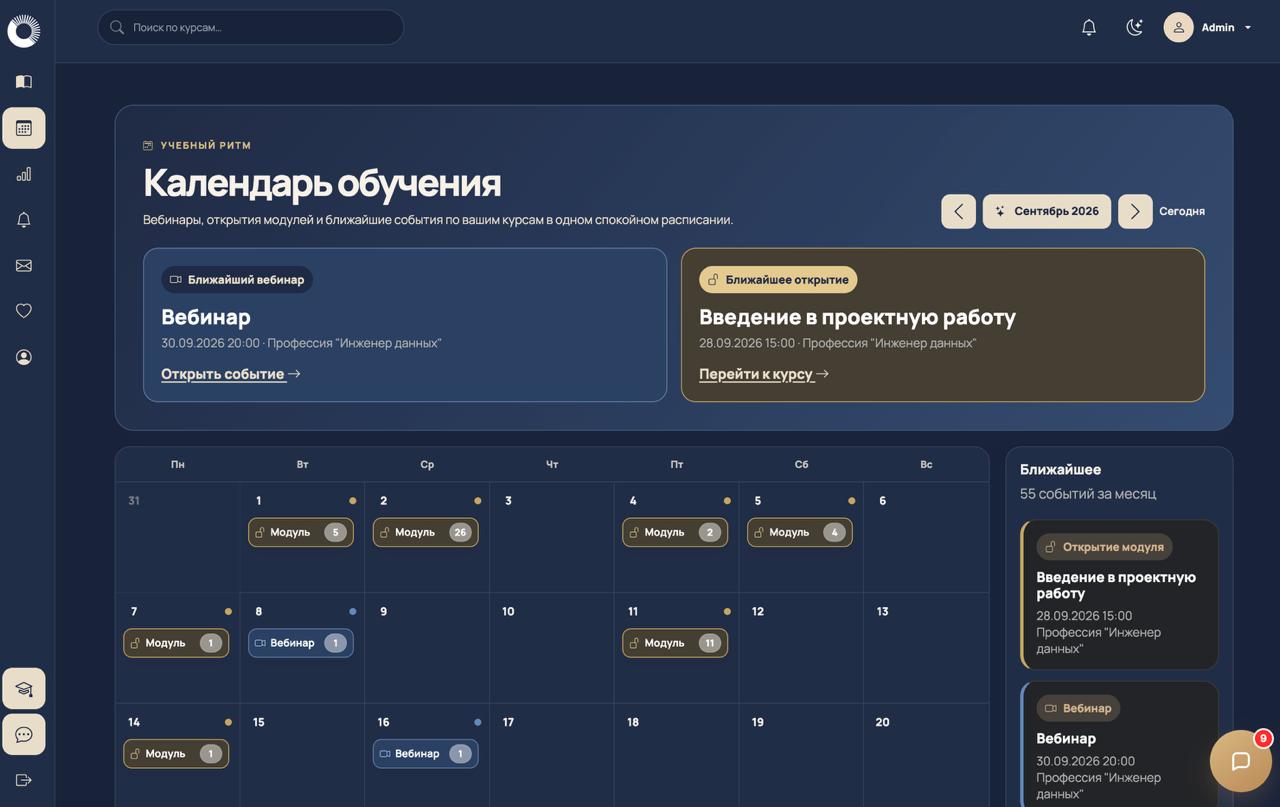
 Нова Дата СДО — в реестре российского ПОРеестровая запись № 34931