Блог

15
Как Spark отбирает нужные данные ещё при чтении источника
Для отчёта часто нужна лишь часть исходной таблицы. Объясняем перенос фильтра к источнику, выбор столбцов и причины, по которым экономия не гарантирована.

10
Как подготовить учебные материалы для разных способов восприятия
Заголовки, проверенные субтитры и текстовое описание помогают получать содержание разными способами. Разбираем подготовку одного учебного фрагмента для команды.

8
Data Vault: зачем разделять сущности, связи и историю данных
Разбираем хабы, линки и сателлиты на условной службе проката. Показываем, какую задачу решает Data Vault и почему это ещё не готовый отчёт.

15
Зачем новому расчёту отдельный переключатель включения
Доставить обновление и начать использовать новый расчёт можно в разное время. Объясняем переключатели функций, условия возврата и ограничения такого подхода.

19
Дата и момент события: почему это разные данные для отчёта
Календарный день не показывает точное время, а добавленная полночь не возвращает неизвестные сведения. Разбираем, какую подробность времени требует задача и что теряется при преобразовании.

16
Почему таблицу из PDF нужно проверить перед загрузкой в отчёт
На странице видна аккуратная таблица, но после извлечения столбцы могут сместиться. Объясняем различия текста и скана и предлагаем проверку строк, заголовков и итогов.

18
Почему Spark не всегда правильно угадывает типы данных в файле
Столбец из цифр может быть суммой или кодом, в котором важны начальные нули. Объясняем автоматическое определение структуры файла и роль заранее согласованной схемы.


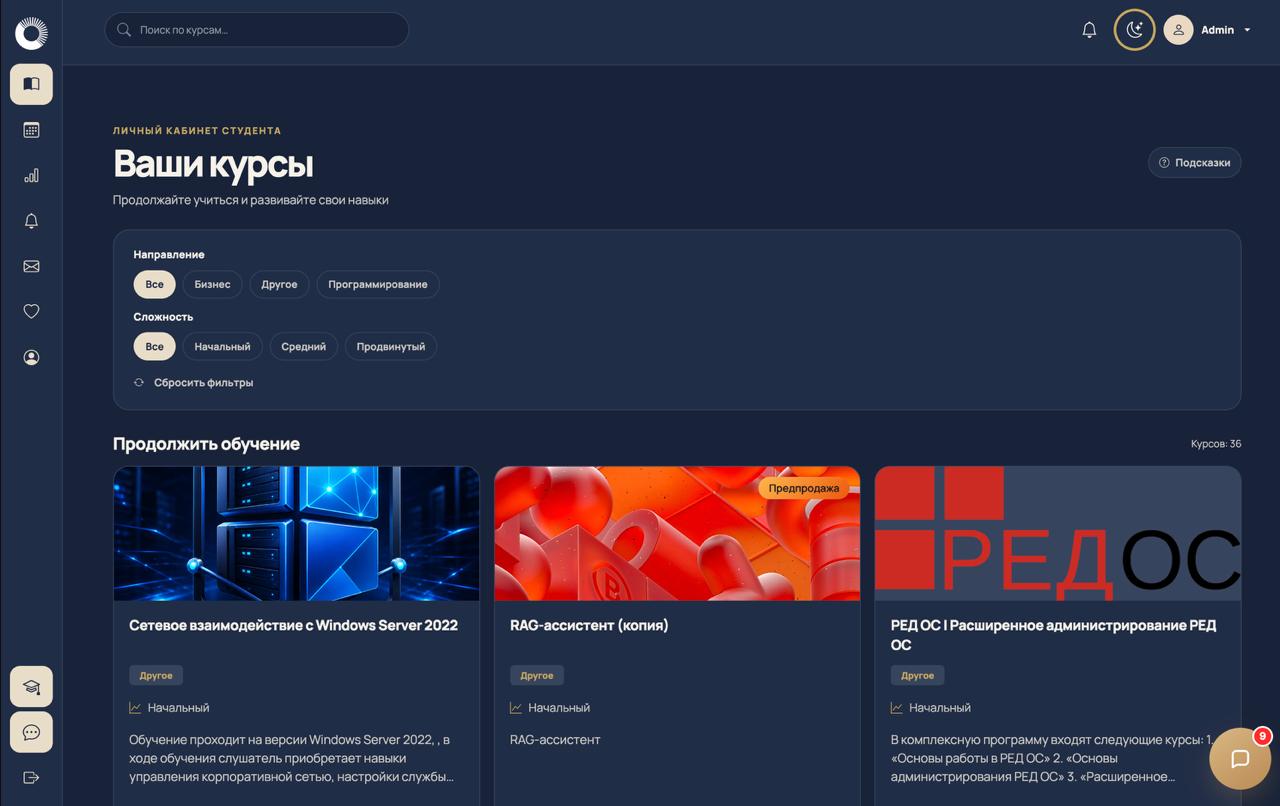
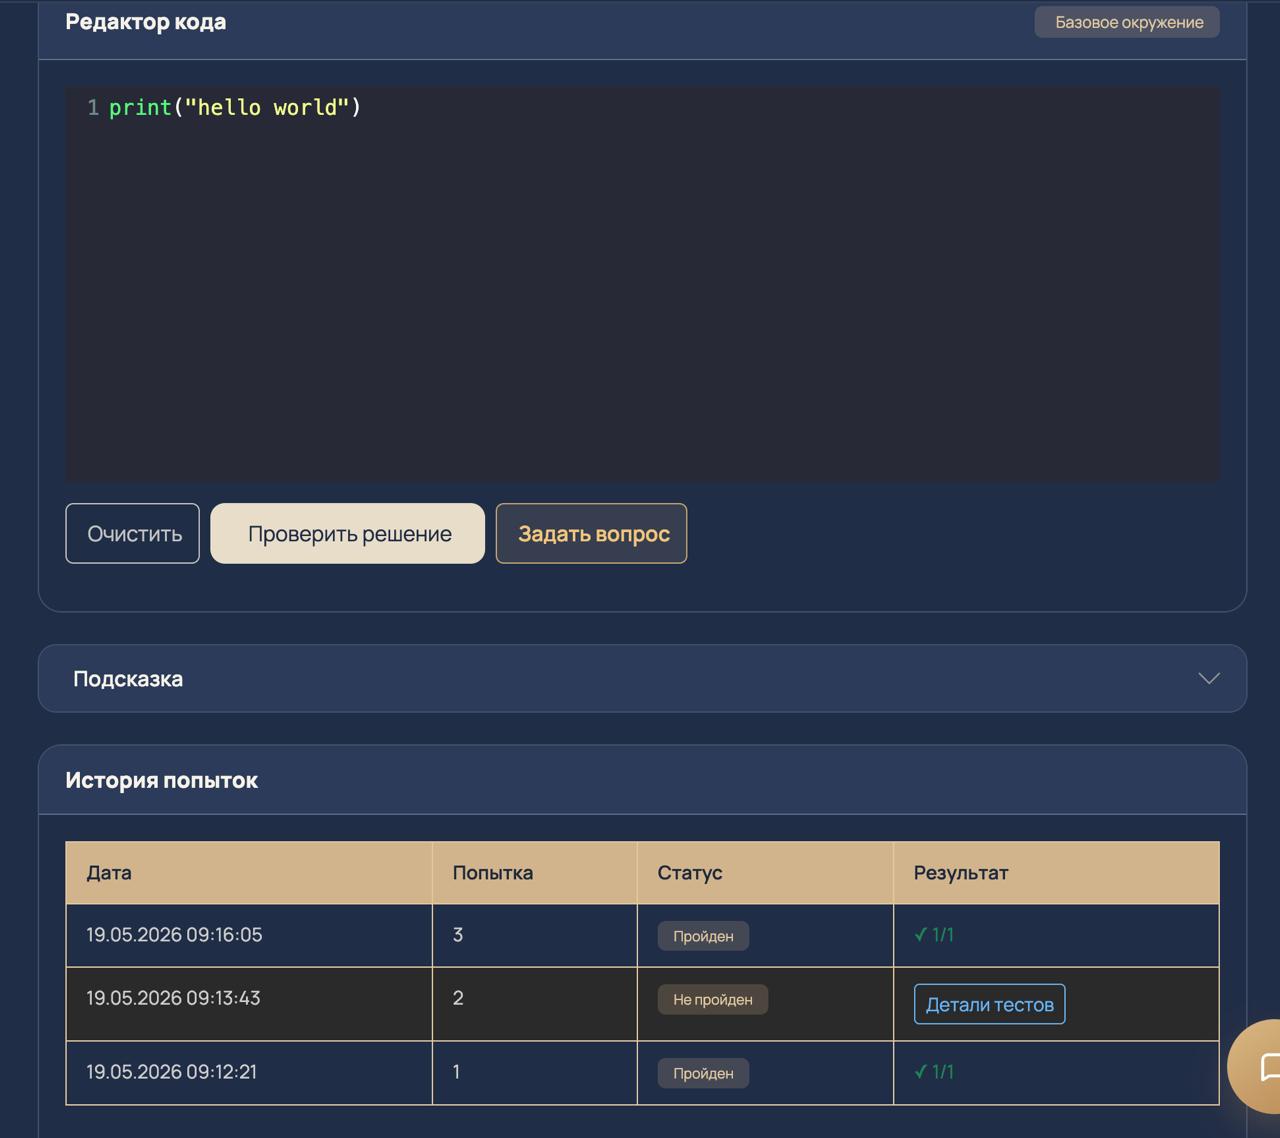
Занятия проходят
в Нова Дата СДО
Вебинары, практика и общение с преподавателем — в одном окне браузера.
Посмотреть интерфейс платформы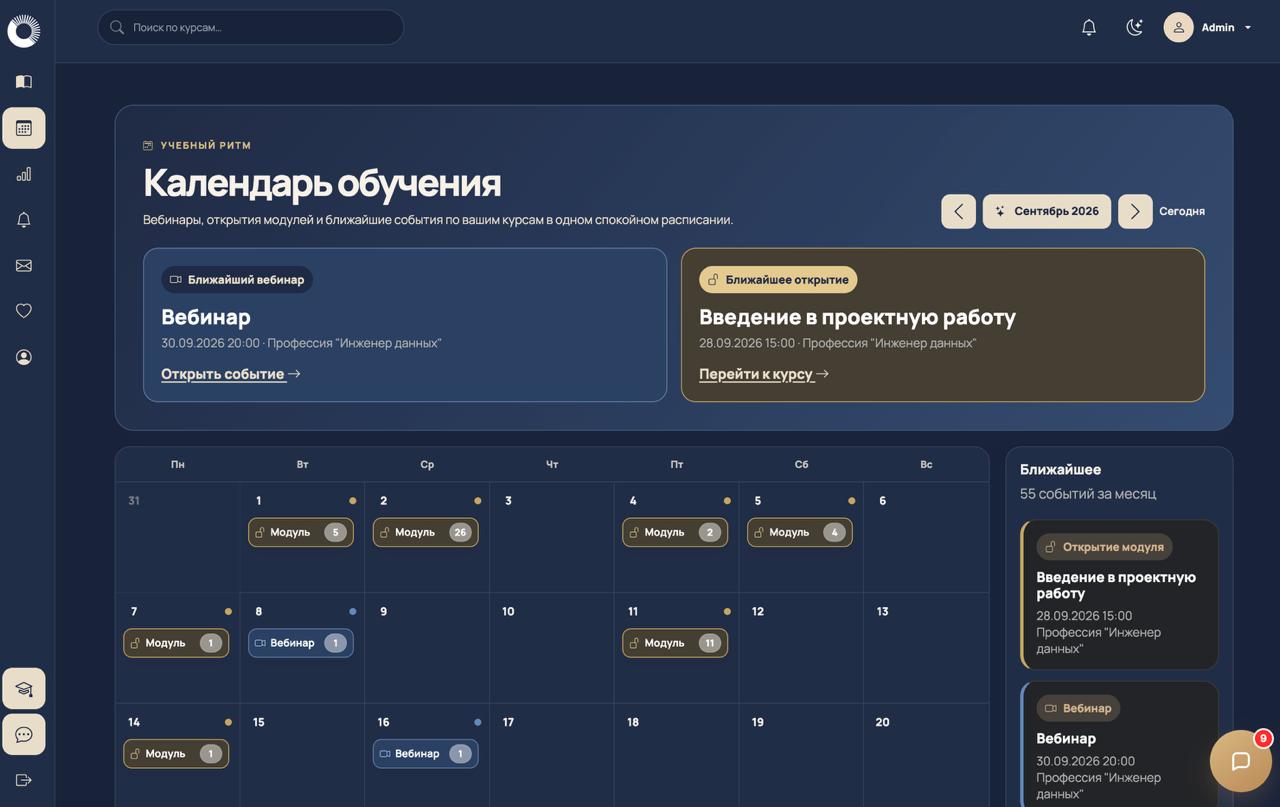
 Нова Дата СДО — в реестре российского ПОРеестровая запись № 34931