Блог

10
Добавить или обновить: как Spark выдаёт результат потокового расчёта
Поток покупок меняет итог по магазину. Разбираем три режима вывода Structured Streaming и объясняем, почему получатель должен понимать, что означает очередная строка.

12
Зачем команде библиотека разборов учебных ошибок
Одинаковая ошибка повторяется в разных учебных проектах. Предлагаем способ сохранять обезличенные разборы: от наблюдения и причины до новой самостоятельной проверки.

10
Lakehouse: как совместить озеро данных с возможностями хранилища
Одним командам нужны файлы для исследований, другим — устойчивые таблицы для отчётов. Объясняем идею Lakehouse, роль метаданных и ограничения обещания единой платформы.

10
Зачем системе данных искусственная контрольная запись
Сервер отвечает, но запись может не доходить до отчёта. Объясняем, как безопасный тестовый пример помогает проверить весь путь данных и что он не способен доказать.

12
Составной индекс: зачем базе несколько полей и почему важен порядок
Поиск по городу и дате отличается от поиска только по дате. На примере справочника разбираем составной индекс PostgreSQL и ограничения правила о первом поле.

15
Контрольная сумма файла: как проверить, что данные дошли целиком
Одинаковое имя и размер ещё не означают одинаковое содержимое. Объясняем проверку файла по контрольной сумме и её границы на простом примере передачи выгрузки.

16
Watermark в Spark: сколько ждать запоздавшие события
Покупка произошла раньше, чем поступила в обработку. Объясняем временную границу Spark, отличие от часов на стене и компромисс между опозданиями и хранением состояния.


Занятия проходят
в Нова Дата СДО
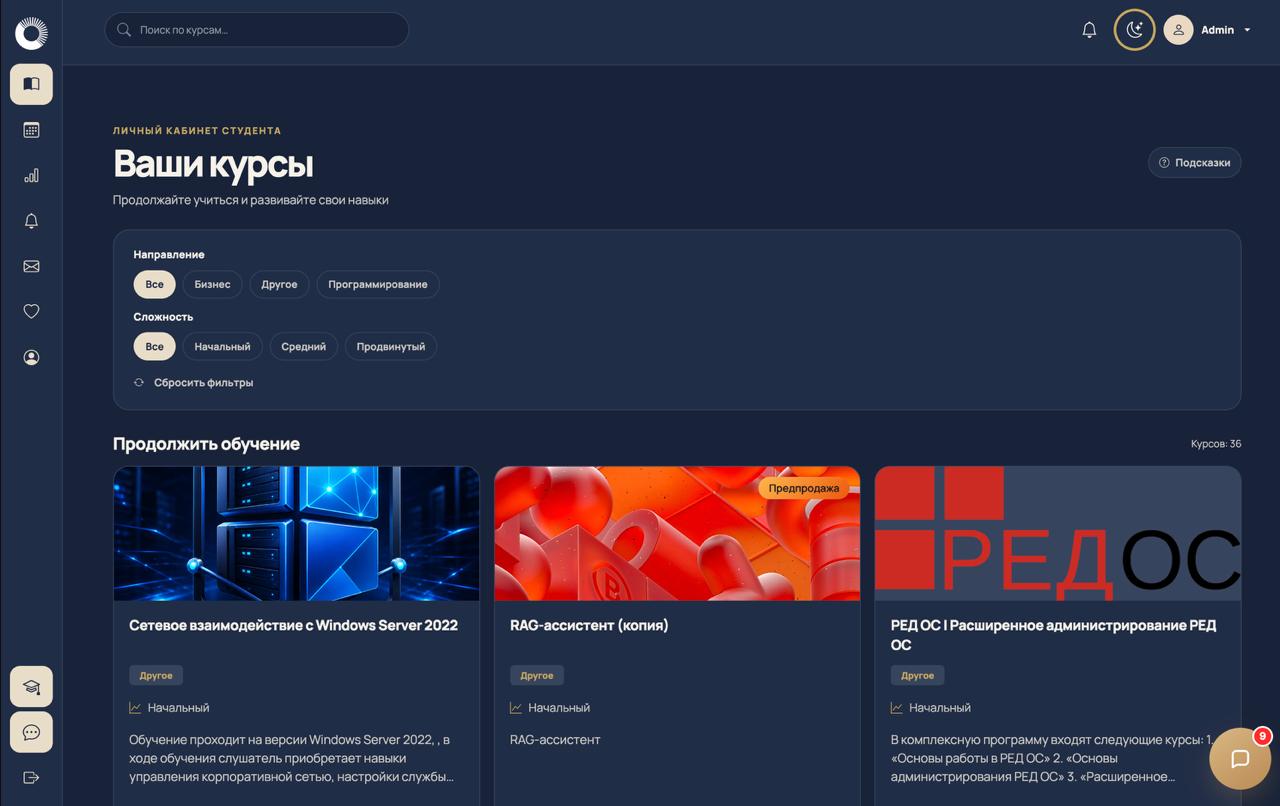
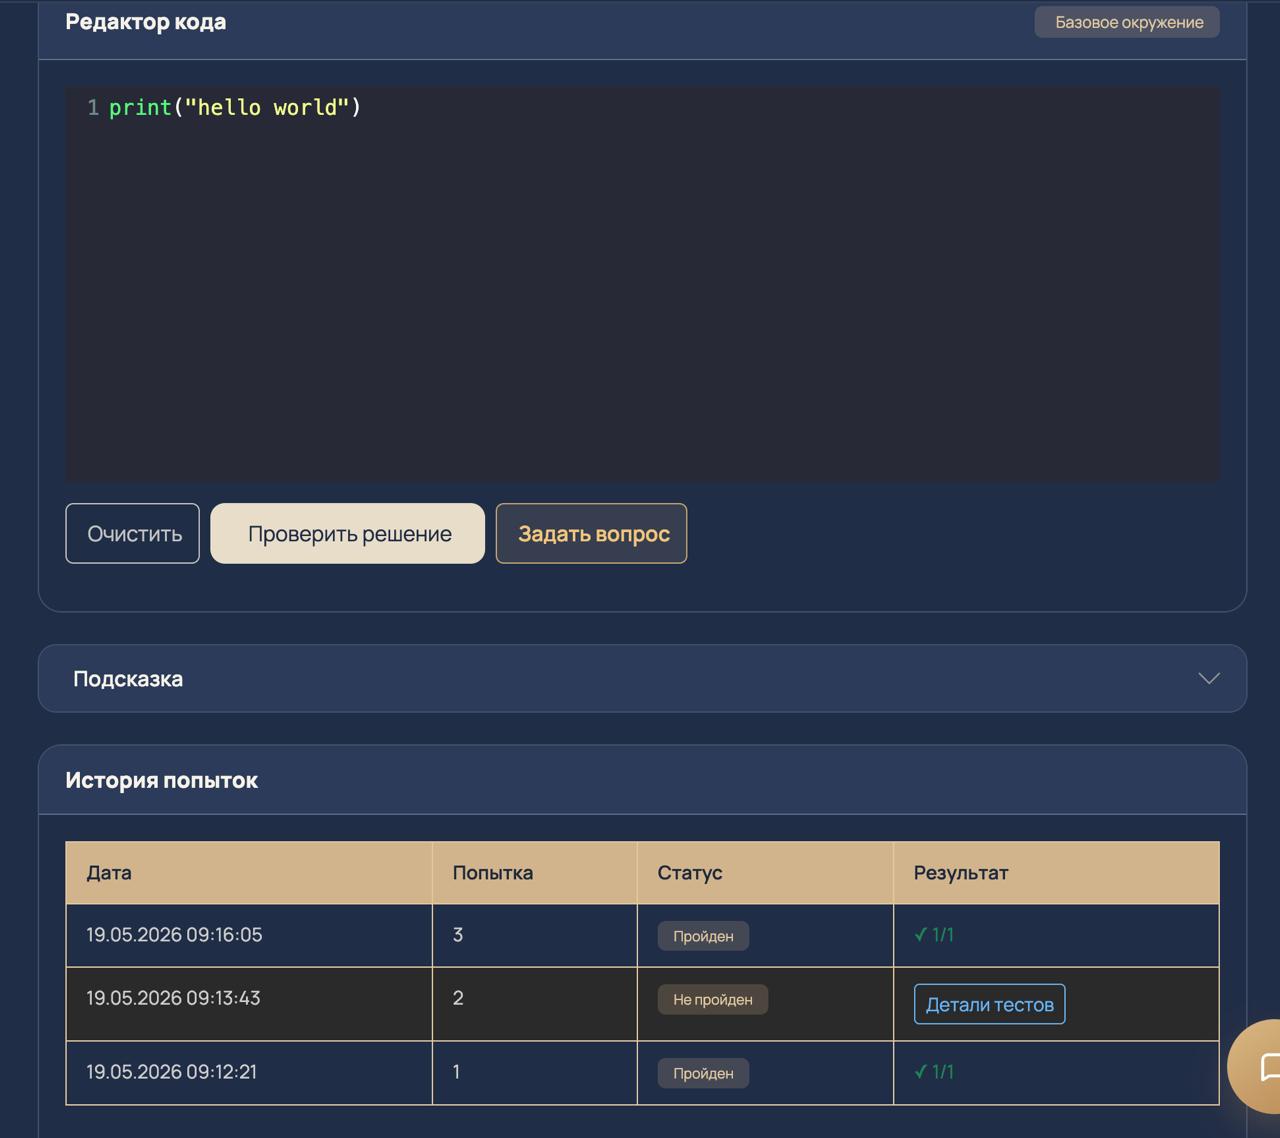
Вебинары, практика и общение с преподавателем — в одном окне браузера.
Посмотреть интерфейс платформы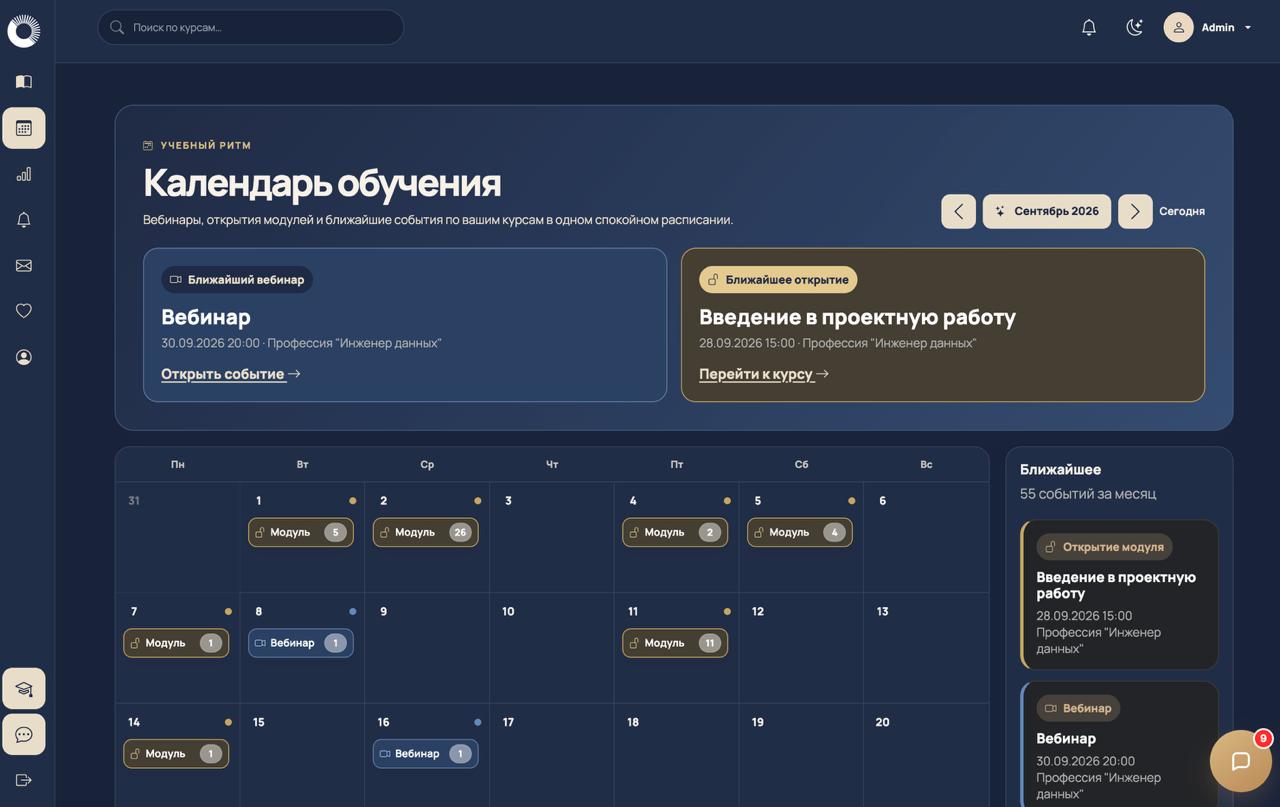
 Нова Дата СДО — в реестре российского ПОРеестровая запись № 34931