Блог

46
Зачем Spark раздаёт маленькую таблицу всем узлам
Объясняем broadcast в Spark без кода: зачем небольшую справочную таблицу копируют рабочим узлам, когда это помогает и где упирается в память.

50
Кто отвечает за данные и показатель в отчёте
Как разделить ответственность за определение показателя, качество исходных данных и техническую доставку, чтобы спорные цифры не оставались без ответа.

45
Как строки превращаются в итог по группам
Что такое группировка данных в отчёте: как из отдельных продаж получить итоги по магазинам и почему сначала нужно выбрать уровень детализации.

48
Почему одно событие попадает в данные дважды
Как повторная доставка сообщения создаёт дубли в аналитике, почему она бывает допустимой и что нужно согласовать до подсчёта заказов.

40
Горячие и холодные данные: почему их хранят по-разному
Что означают горячие и холодные данные, как частота чтения влияет на место хранения и почему дешёвый архив не всегда экономит деньги.

80
Почему Spark не хватает памяти, хотя кластер большой
Почему большой кластер Spark не спасает от нехватки памяти драйвера. Объясняем сбор результата в один процесс и способы уменьшить итоговую выгрузку.

86
SLO для данных: как договориться о надёжности отчёта
Что такое SLO для данных: как определить приемлемую надёжность, выбрать измерение и договориться о действиях при нарушениях. Простой пример.


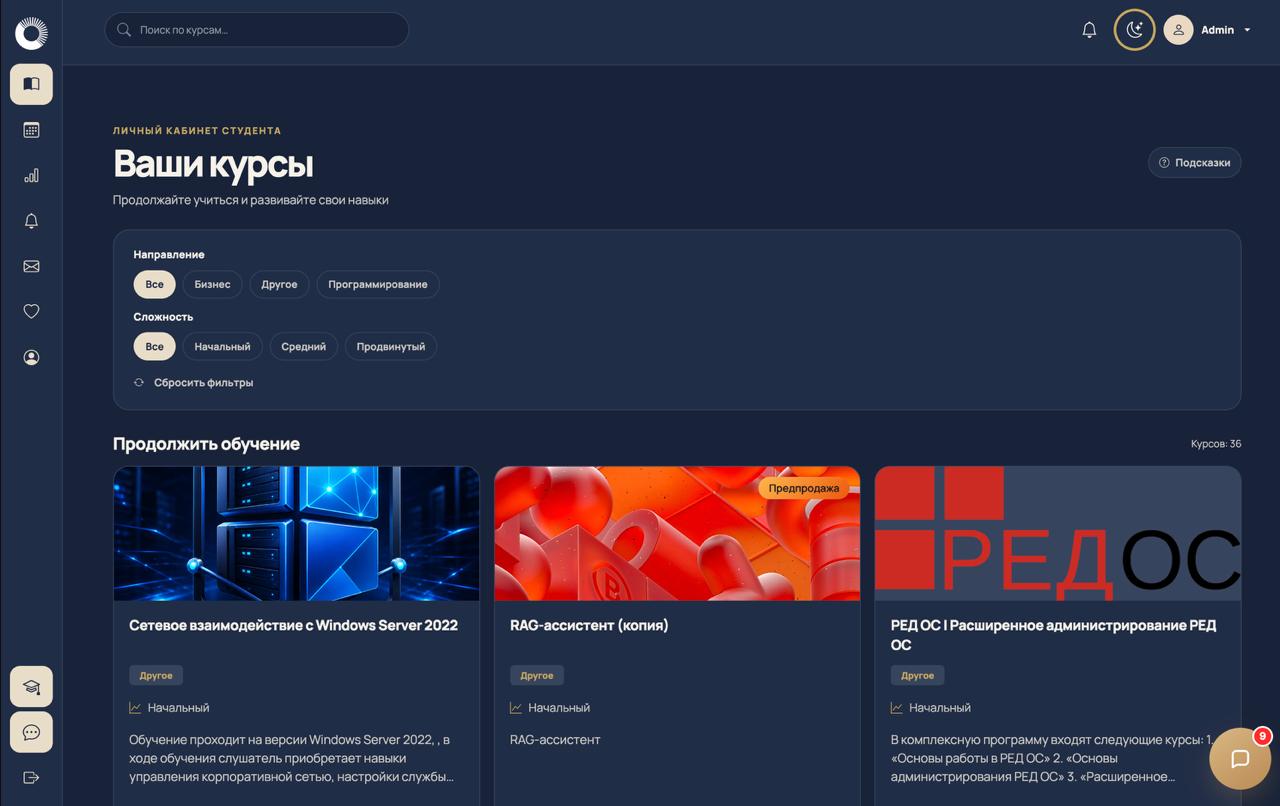
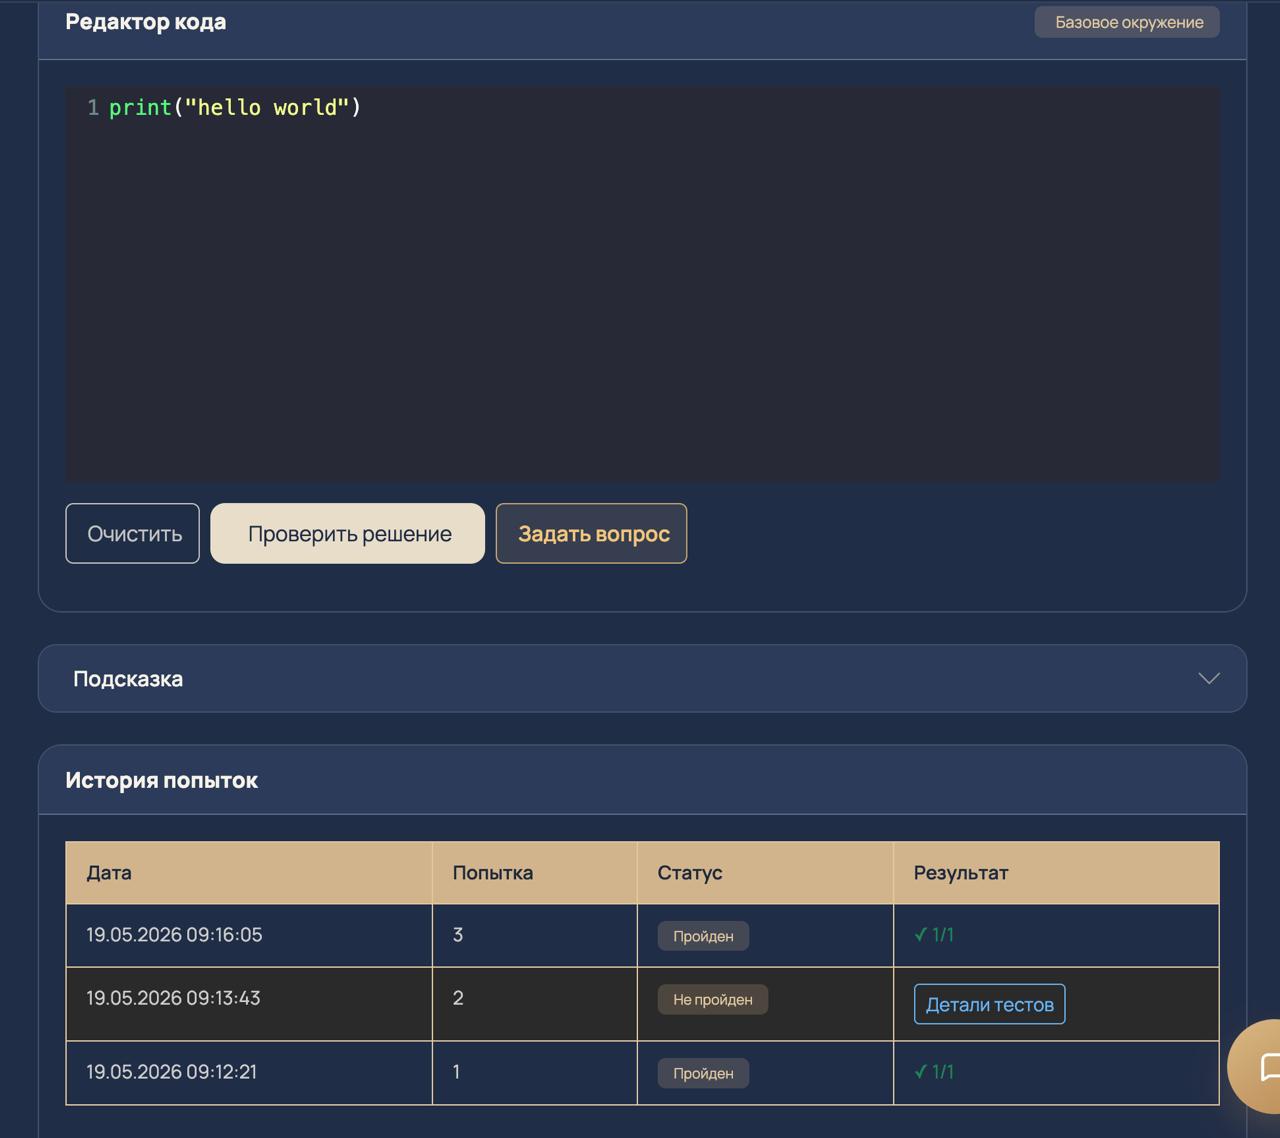
Занятия проходят
в Нова Дата СДО
Вебинары, практика и общение с преподавателем — в одном окне браузера.
Посмотреть интерфейс платформы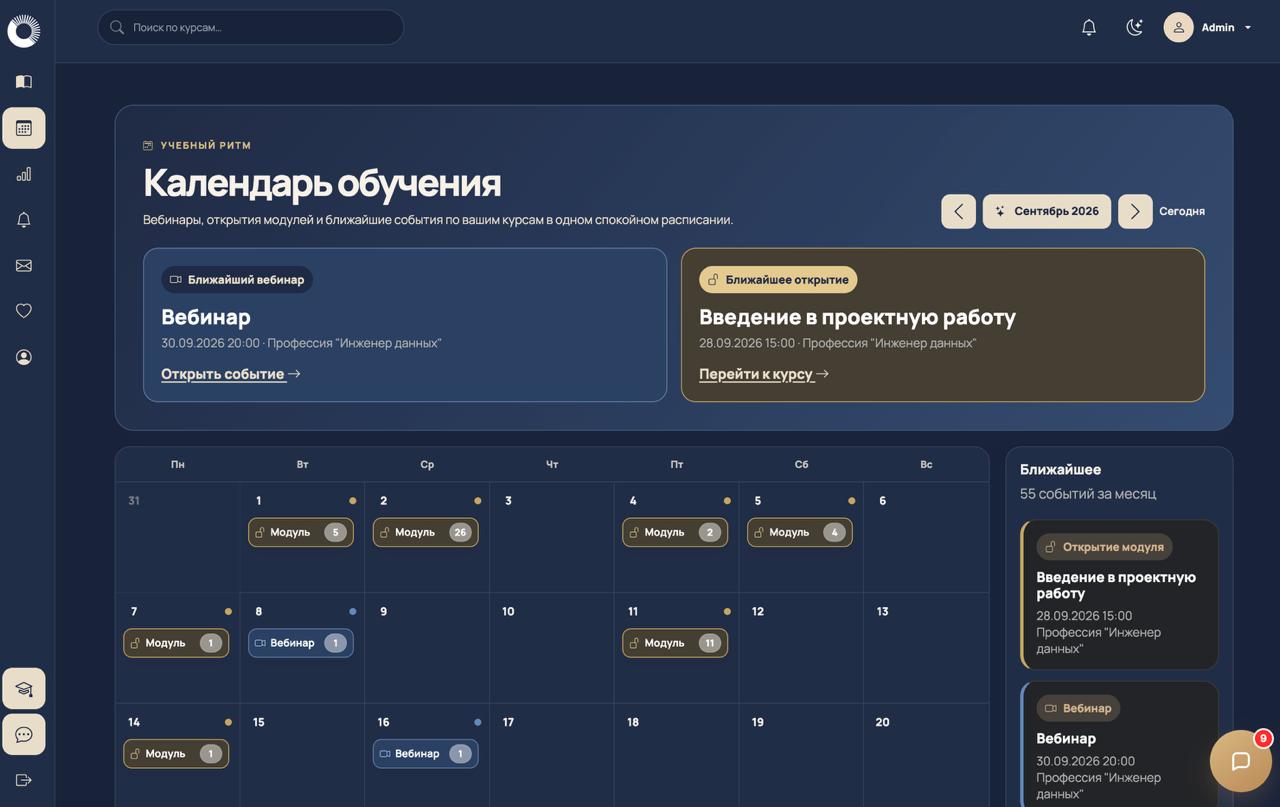
 Нова Дата СДО — в реестре российского ПОРеестровая запись № 34931