Блог

30
Встроенные функции и UDF в Spark: когда нужно своё правило
Чем готовые операции Spark отличаются от пользовательской функции, когда она действительно нужна и как оценить последствия выбора без программирования.

29
Сообщество практики в команде данных: как делиться рабочими решениями
Зачем специалистам по данным регулярный обмен опытом, как сделать встречи полезными и когда такой формат не решает проблему обучения.

58
Строчное и колоночное хранение: почему отчёты читают данные иначе
Объясняем, как расположение значений влияет на чтение таблицы, когда полезен каждый подход и почему один формат не заменяет другой.

65
Критичность сбоя данных: как выбрать порядок реакции
Как оценить влияние сбоя данных на людей и решения, отличить срочную проблему от плановой и пересмотреть приоритет при новых фактах.

21
Материализованное представление: почему быстрый отчёт может отставать
Простое объяснение сохранённого результата, его обновления и выбора между скоростью отчёта и свежестью данных.

62
Пагинация API при загрузке данных: как не потерять часть записей
Почему API отдаёт данные частями, как понять, что загружены все страницы, и что делать, если источник меняется во время чтения.

31
Адаптивный план Spark: как обработка меняется по ходу работы
Что такое адаптивное выполнение в Spark, какие сведения система получает во время обработки и почему это не исправляет любую медленную задачу.


Занятия проходят
в Нова Дата СДО
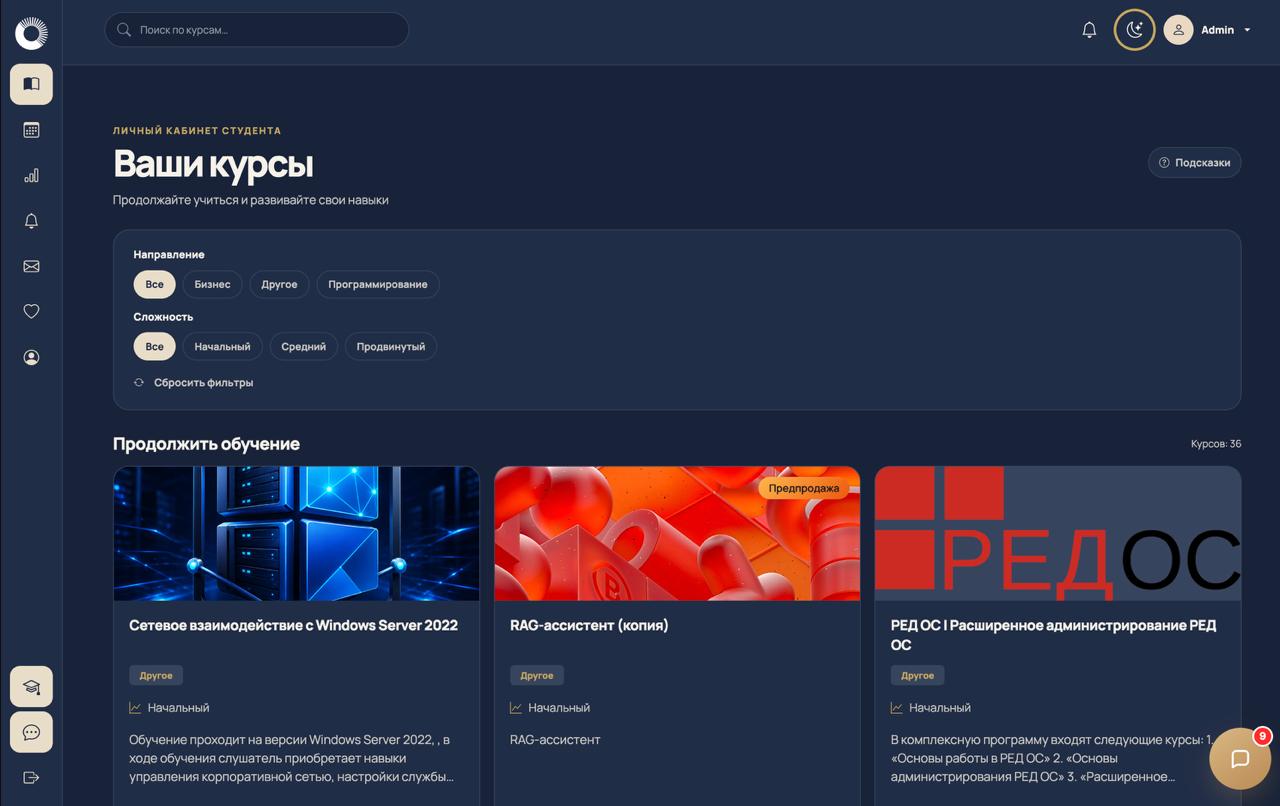
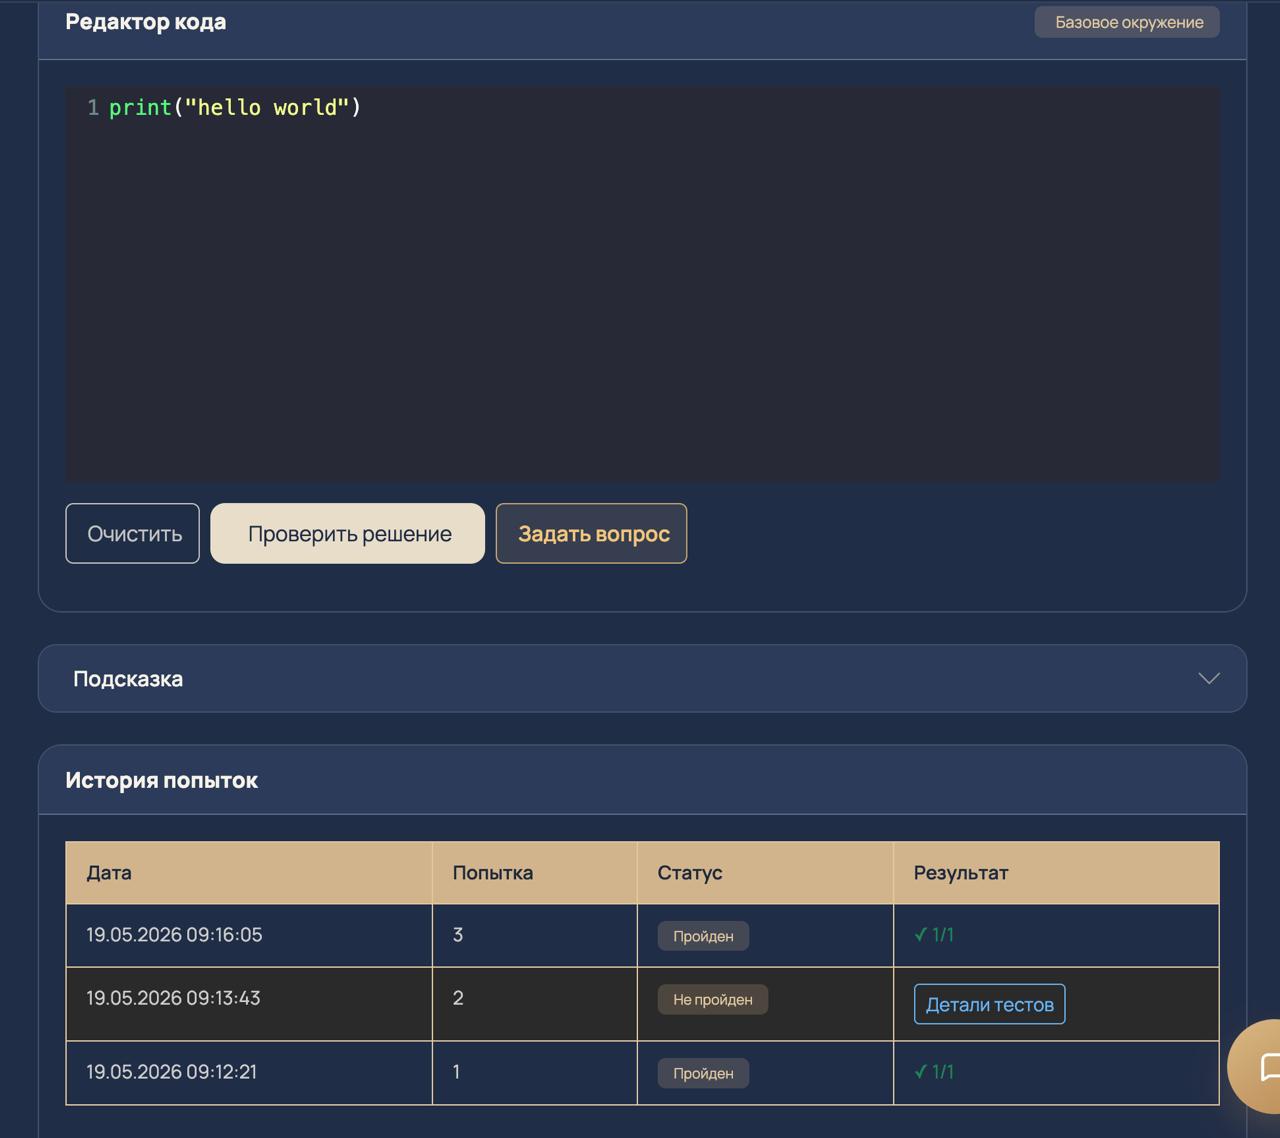
Вебинары, практика и общение с преподавателем — в одном окне браузера.
Посмотреть интерфейс платформы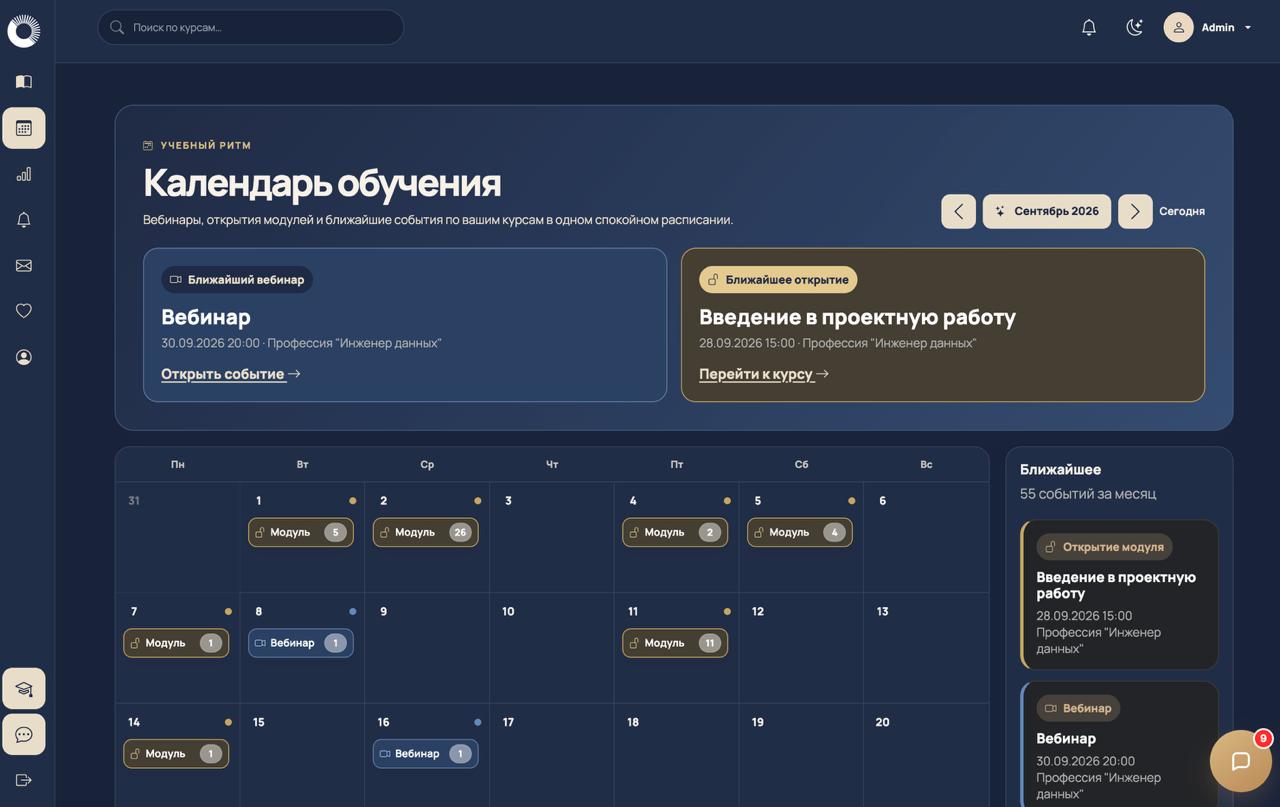
 Нова Дата СДО — в реестре российского ПОРеестровая запись № 34931